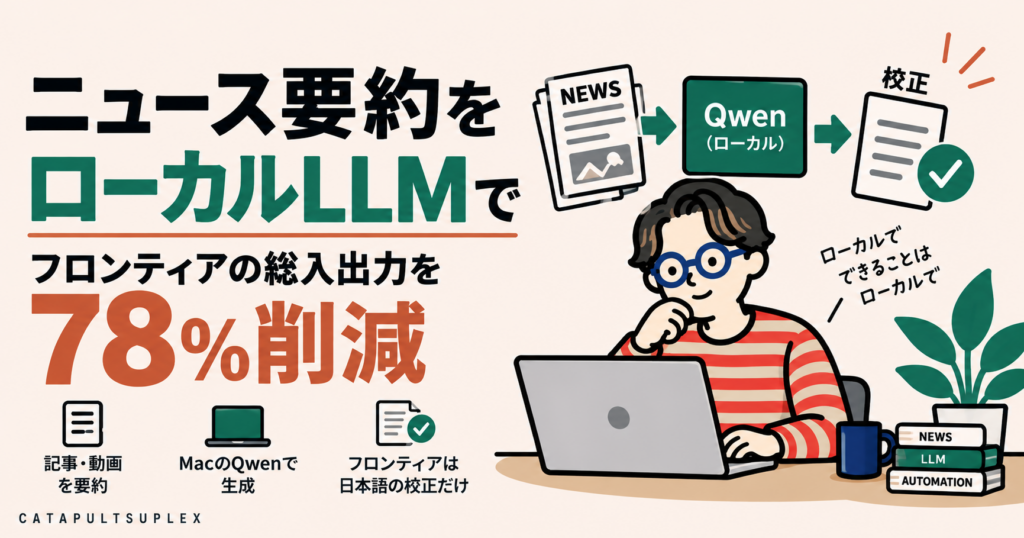
カタパルトスープレックスでは、海外のテクノロジーやビジネスの記事を集め、日本語のニュース要約をDiscordで配信しています。その要約を作るために使っている自作スキルが「Katapult Summarize」です。また、日々の記事をもとにニュースレターを作る別のスキル「Katapult Weekly」を使い、毎週Substackで配信しています。前回は、そのニュースレターを作る別のスキル「Katapult Weekly」に、ローカルLLMのQwenとJevを組み込む実験を紹介しました。
今回は、その前段にある日々のニュース要約をするスキルをQwenへ移す実験です。2026年10月12日にクリップした28件を、フロンティアモデルで生成する方式と、Mac Studio上のQwenで生成する方式で比べました。要約ができた後の日本語校正は、両方式とも同じ軽量モデルが1回だけ担当しています。
結果は、Qwen方式でフロンティアモデルの総入出力トークンを78.0%削減できました。比較用の保存まで両方式とも28件を処理し、Qwen方式を今後の日々の要約に採用しました。そのうち未配信だった26件は、通常のニュース保存先へ取り込み、Discordで実際に配信しています。前回のWeekly実験では従来方式を維持しましたが、今回は採用という違う結論になりました。
自作スキルの中身
Katapult Summarizeは、Discordで配信する日本語のニュース要約を作るための自作スキルです。クリップした記事やYouTubeの字幕から入力を取り出し、要約とタイトルを作り、校正してObsidianのノートへ保存する手順をまとめています。
利用者の操作は、読みたい記事をクリップするところから始まります。取得できる記事は本文を取り出し、自動取得が難しい記事はクリップ時のメモへ本文を貼ります。YouTubeでは字幕を入力にします。保存したURLと原題を保ちながら、日本語で何が起きたのか、重要な詳細は何か、どんな意味があるのかを説明します。
今回の入力は記事でしたが、同じ手順で記事と字幕を扱います。通常の記事は3段落、短い記事は2段落が基本です。情報が少ない記事を長くするために背景を足したり、同じ結論を繰り返したりしません。原文に書かれた内容を、読者が短時間でつかめる長さにまとめるのが目的です。
保存された要約は、Discordの日々のニュース配信に使います。一つの記事を紹介する段階では、その記事の話題と重要な情報が伝われば役に立ちます。一方、毎週Substackで配信するニュースレターでは、複数の記事をテーマごとにつなぎ、前週までの経緯も含めて説明します。その制作手順がKatapult Weeklyです。
目的は、日々の要約を効率化し、フロンティアの利用を減らすこと
従来は、CodexやClaude Codeなどで使うフロンティアモデルが、原文を読み、要約と日本語タイトルを書いていました。ニュースを毎日扱うため、一つの記事への利用が小さくても、記事数と処理する日数に応じて入力と出力が積み重なります。
そこで、文章を読んで要約する仕事を、手元のMac Studioで動くQwenへ移せないかと考えました。フロンティアモデルを使うのは、生成された日本語を整える校正だけにします。今回の比較では、フロンティアでの生成をGPT-6.1 Sol、校正をGPT-6 Lunaが担当しました。Qwenは、導入済みのQwen 3.8の27BモデルをOllama経由で使いました。
トークンはモデルが文章を読む・書くときの処理単位で、日本語の文字数とは一致しません。今回の主な目標は、フロンティア側の入力と出力を減らすことです。Qwenのトークンを少なくすること自体は目的にしていません。ローカルで処理でき、時間や機器の負担が許容できるなら、Qwenへ任せる量が増えてもかまいません。
方向性は、Python・Qwen・校正担当の分担
基本の考え方は、前回のWeekly実験と同じです。Qwenがシンプルな仕事をできるように、収集や保存を含む前後の処理を別の担当へ分けます。
入力ファイルを読むこと、送信する量を調整すること、順番に要求すること、返答を保存することはPythonが担当します。Qwenは、渡された本文から日本語の要約とタイトルを生成します。最後に、軽量なフロンティアモデルが日本語だけを校正します。要約を生成する仕事と、原稿を保存する操作を同じ会話の中で何度も相談しません。
関連する継続テーマも、要約と同じ要求でQwenが選びます。事前に定義した候補を渡し、存在しない名前は既存の保存処理が受け付けません。フロンティアによる分類の再確認は置きませんでした。
この分担では、Qwenへ原文を渡すPythonと、日本語を整える校正担当の間に、制作を監督するフロンティアモデルを追加しません。Qwenの出力をフロンティアが原文と照合し、内容を選び直し、文章を組み立て直すなら、生成を移した効果が小さくなるからです。
Qwenへは原文と短い依頼を渡す
Qwenを使ううえで意識したのは、前提条件を増やしすぎないことでした。過去のニュース系の試行では、長い規約や工程管理を取り込ませるより、原文を素直に渡し、何を作るのかを短く依頼した方がよい結果が出ていました。
今回も、文章規約の全文や、これまでの試行の経緯はQwenへ渡していません。「原題と本文から日本語のニュース要約を作る」「発言者、数字、条件、反論、留保を保つ」「原文にない情報を足さない」という、その要求に必要な条件を渡しました。要約とタイトル、継続テーマの選択は一つの生成要求で返します。
タイトルは、原題の焦点と主体を保つ
最初の金曜日の20件を使った比較では、タイトルにも問題が見つかりました。従来の指示は、記事全体から結論を選び、日本語の短い見出しを新しく作ることを強く求めていました。原題は渡していても、記事の識別に使うだけという扱いです。
そこで、「原題を参考にし、原題の焦点と誰が何をしたかを保つ」という指示へ変えました。逐語訳は求めません。原題が問いならその問いを、発言者の主張なら誰の主張かを残し、自然な日本語にします。本文の全要素をタイトルへ詰め込むこともしません。
25字は目安にしました。字数を守るために主体や対象を削り、見出しだけでは意味が取れなくなるなら、少し長い方を選びます。例えば、AIエージェントのプライバシー保護を扱う記事では、企業の約束が実際に守られるかという焦点を残すことが、短い抽象語へ置き換えることより大切です。
フロンティア側の確認を減らさなければ、削減は小さくなる
最初の比較でも、Qwenへ生成を移すことでフロンティアの利用は減りました。しかし、日本語の本文校正とは別に、タイトルが論旨に合うか、タイトルだけで読めるかという判定を置き、修正後に再判定していました。Qwenの生成後に、複数のフロンティア要求が続く工程です。
判定者が担当範囲を超える指摘を出すこともありました。本文に根拠がある補足を、原題にないという理由だけで否定する例です。それを避けるために指示を補足し、もう一度判定すると、さらに入力と出力が増えます。最初は問題を減らすために置いた工程が、対応する作業を増やしていました。
そこで、今回採用した方式では、本文とタイトルをまとめて一人が直接校正する形へ変えました。原文との照合、帰属や条件の再確認、数値の検証、タイトルの別判定は追加しません。Qwenの要約をフロンティアが別の原稿へ書き直すことも外しました。
もちろん、この変更は内容の誤りを解決する方法ではありません。確認を減らせば、元の意味を取り違えた箇所が残る可能性はあります。その点は、実験の結果として隠さず示し、トークンの削減と内容の同等性を別に考えました。
yomiyasuは日本語を整え、校正担当が直接修正する
日本語の校正には、前回と同じくyomiyasuの考え方を使いました。yomiyasuはモデルではなく、意味を保ちながら不自然な日本語を整えるための文章の規律です。翻訳調、主語と述語の対応、修飾語のかかる先、名詞を詰め込んだ表現などを扱います。
校正は生成担当とは独立したGPT-6 Lunaが担当しました。渡すのは日本語の本文とタイトルだけです。元記事、作業メモ、他担当の判定、規約全文は渡さず、日本語を最小限で直します。
「ここがおかしい」と指摘だけを返し、別のチャットや生成担当に直させる方式もやめました。校正担当が、保存にそのまま使える修正文言を返します。Pythonがその修正を当て、保存します。修正版を別のモデルへ戻す工程は置かず、校正担当がその場で文を読み返して終えます。
28件を両方式で新しく作り、同じ工程で比較した
最終比較の対象は、2026年10月12日にクリップした28件です。記事の公開日が10月12日のものだけを集めたわけではありません。入力は記事取得結果と、クリップ時に保存した本文メモで、合計252,935字でした。以前の日本語要約を流用せず、同じ入力から両方式で新たに生成しています。
フロンティア方式は、GPT-6.1 Solへ7件ずつ、計4回に分けて原文を渡しました。Qwen方式は記事ごとに処理します。両方式とも同じ要約形式と、原題を参考にする指示、定義済みの継続テーマを使い、生成後に一回だけ直接校正しました。
Qwenの実行では、コンテキストを32,768、出力上限を4,096トークンとし、思考モードを使わず処理しました。これはこのMacと導入済みモデルで使った実験条件です。Qwen一般の性能上限や、どの機器でも同じ量を扱えることを示す数字ではありません。
今回は比較をわかりやすくするため、フロンティア方式にも新しい直接校正を適用しています。昔の重いタイトル判定をフロンティア側だけに残して、Qwenの優位を大きく見せる比較にはしていません。違いの中心は、原文から要約を生成する担当です。
約9万字の長文は、Pythonで分けてQwenが整理した
最長の入力は、AIによる研究開発の自動化を扱うEpoch AIの記事で、89,701字ありました。短いニュースを一つずつ渡すだけでは、長い調査記事やYouTubeの字幕を扱う方法がわかりません。この入力では、長文の処理も試しました。
Pythonが最大50,000字を目安に、段落や空白の区切りを使って二つに分割しました。Qwenは各部分から、記事全体の要約に使う日本語の整理メモを作ります。その後、二つのメモをQwenへ渡し、一つの記事として本文とタイトルを生成しました。フロンティアは、この完成した日本語の校正だけを担当しています。
分割を決めたのはPythonです。どの主張や数字をメモへ残すかはQwenが判断しました。Jevが重要な段落だけを選んだり、フロンティアが抜けた内容を追加したりしたわけではありません。元の入力を二つとも処理したことと、要約に必要な情報が同じように残ったことは別です。
実際に読み比べると、中心となる研究の話題は両方式で説明できていましたが、フロンティア稿には、評価条件によって35%と15%に変わる数値の説明やGPU費用、結果の解釈に関する留保があり、Qwen稿にはありませんでした。どこまでを残すかに差があります。
この差が分割したことで生まれたのか、Qwenが要約するときの選択によるのかは、今回の一回の比較では分離できません。長文を処理できたからといって、情報の保持まで同等とすることは避けました。また今回の入力は記事であり、YouTube字幕を同じ条件で試した結果ではありません。
フロンティアの総入出力は78.0%減った
結果は次のとおりです。表の入力・出力はフロンティアモデルの利用で、Qwen自身のトークンは含みません。Qwen方式では、フロンティアモデルが担当したのは校正の一回だけです。
| 指標 | フロンティア方式 | Qwen方式 |
|---|---|---|
| フロンティア入力 | 173,065 | 37,993 |
| うちキャッシュ入力 | 60,160 | 11,008 |
| フロンティア出力 | 18,980 | 4,179 |
| 入力と出力の合計 | 192,045 | 42,172 |
| 非キャッシュ入力と出力の合計 | 131,885 | 31,164 |
| フロンティアへの要求 | 5回 | 1回 |
| 比較用の保存と再読込 | 28件 | 28件 |
入力は78.0%減、出力も78.0%減で、入力と出力の合計も78.0%減でした。本文生成をQwenへ移したことで、フロンティアに長い原文を読ませる入力がなくなり、要約本文を生成する出力もなくなりました。校正に使った入力と出力は、減った後の数値にも含めています。
キャッシュ入力は、入力合計の内訳です。モデルの処理で再利用された入力を除き、非キャッシュ入力と出力を足すと、削減率は76.4%です。78.0%と76.4%は、同じ比較を異なる集計方法で表した値です。どちらかを本文制作の成功率や、費用の削減率へ置き換えることはできません。
今回、Qwenは30回の成功した要求を処理し、入力75,032、出力17,093トークンを使いました。28記事の生成に加え、長文を二部分で整理する要求が二回あります。このローカル側の利用も記録しましたが、フロンティアの削減率とは分けています。
処理時間も短くなったが、依頼全体の所要時間ではない
生成と校正のAI要求にかかった時間を合計すると、フロンティア方式は約10分13秒、Qwen方式は約8分13秒でした。約19.7%の短縮です。Qwen側には、長文の整理と統合に加え、途中の失敗にかかった時間も含めています。
この数値は、利用者が依頼してから原稿を受け取るまでの時間ではありません。記事の取得、比較の準備、操作や指示の待ち時間、担当者が原稿を読む時間、報告を書く時間、保存操作などは含みません。両方式は並行して実行したため、要求時間の合計と、作業中に時計で測る時間も一致しません。
実験を管理する調査や報告作成のトークンも未集計です。生成・校正の利用は減りましたが、日々の運用全体やサブスクリプションの利用枠が同じ割合で減ることまでは測っていません。
原稿の読みやすさと内容には差が残った
AIエージェントのプライバシー、Epoch AIの長文調査、ローカルAIの利用体験の三件を、校正後の原稿で読み比べました。追加の判定モデルは使っていません。実際の文章を見て、トークン数だけでは見えない差を確認するためです。
プライバシーの記事では、フロンティア稿は「利用者ごとに仮想マシンへ隔離する」「日間利用者が60万人」と説明していました。Qwen稿には「Linux VM」「DAU」「ゼロデイ脆弱性」などが残っています。扱う情報が近くても、読者に必要な専門知識が違います。日本語の文が読めることと、用語を知らない人にも説明が伝わることは別です。
ローカルAIの利用体験では、毎朝の通知について、Qwen稿は現在は安定して動くと書き、フロンティア稿はその後も何度か動かなくなったと書いていました。これは言い回しだけの違いではありません。今回の校正は日本語に範囲を絞っているので、この状態の違いを解消する工程にはしていません。
適用した校正は、フロンティア方式が1箇所、Qwen方式が67箇所でした。タイトルも含む数です。Qwen稿の日本語を整える負担はありましたが、指摘や修正の件数を、そのまま内容の正解率や品質点数にはできません。判定者の指摘にも、原稿と合わないものが含まれるためです。
停止と返答の不備は、生成済みの結果を保って回復した
実行中には問題がありました。Robot Girl Gangの記事を生成しているとき、Qwenが同じトークンを繰り返し、Ollamaが二回の要求をエラーで終了しました。この一件だけ反復を抑える設定に変え、生成できました。他の記事の設定は変えず、すでに生成した記事や長文の整理メモは再実行していません。
失敗した二回のトークン数は返されなかったため、Qwen自身の入出力の集計には含められませんでした。時間には約15.54秒を含めています。成功した30回だけを見て、操作を挟まずに28件を終えたとすることはできません。
校正の返答にも不備がありました。Qwen側では、修正対象として示された引用が一箇所、入力原稿に一致しませんでした。その置換を無理に当てず、元の文を保持しています。フロンティア側では、校正結果のデータの末尾に余分な閉じ括弧が一つあり、文言を変えずに読み込み対象から外しました。
復旧時に原稿一式を別のモデルへ渡し直していません。生成済みの結果を保ち、問題箇所だけを扱いました。ただし、対応を挟んだ今回の実験を、無介入で動く自動運用の証拠にはしていません。
期待したことに対して、どこまで結果が出たか
| 期待したこと | 今回の結果 |
|---|---|
| 要約生成をQwenへ移し、フロンティア利用を減らす | 総入出力78.0%減。フロンティアの担当は直接校正一回になった |
| 前処理と保存をコードで進める | Pythonで入力準備・逐次実行・保存を行い、両方式28件を比較用に保存した |
| 長い資料も扱う | 約9万字の記事を二つに分けてQwenで整理・統合できた。情報の保持が同等とは未確認 |
| 日々の処理を速くする | 測定したAI要求時間は19.7%減。依頼全体の時間短縮は未測定 |
| 通常の配信に使う | 未配信26件のQwen原稿を保存し、Discord配信に成功した |
日々の要約にはQwen方式を採用し、Discordへ配信した
比較後、Katapult SummarizeはQwen方式を採用しました。今後は、Qwenが本文とタイトルを生成し、軽量なフロンティアモデルが日本語を一回だけ直接校正する分担を標準にします。Qwenの生成後に、独立したタイトル判定や原文照合を追加する工程は置きません。
今回作ったQwen原稿のうち、未配信26件は通常のニュース保存先へ取り込み、継続テーマを更新して、Discordへ配信しました。26件とも成功応答と配信済み記録を確認し、投稿失敗はありませんでした。
28件すべてを新たに配信したわけではありません。二件は、以前に配信した記事と同じURLでした。既存の配信済み管理を使って二重投稿を避け、過去のノートを保持しました。比較の対象件数は28件、新しく配信した件数は26件です。
前回のニュースレター制作では、旧方式の説明のわかりやすさを優先して、Katapult Weeklyを従来方式のまま維持しました。今回は、記事ごとの要点を日々届けるKatapult Summarizeに限り、Qwen方式を採用しています。二つの判断は矛盾しません。作るものと、必要な編集の範囲が違うからです。
モデルを変えるだけでなく、担当から仕事を外す
今回の実験で効果があったのは、ローカルLLMへ要約を任せることに加え、フロンティア側の仕事を校正だけに絞ったことです。生成した内容を確認する担当、タイトルを判定する担当、その修正版を再判定する担当を残したままでは、利用を十分に減らせませんでした。
前提条件を増やさず、Qwenへ原文と短い仕事を渡す。必要な量への調整や操作はPythonで行う。日本語の修正は軽量モデルが直接返し、別の担当との往復を作らない。この組み合わせで、今回の28件ではフロンティアの総入出力を78.0%減らせました。
ローカルモデルを使える仕事と、広い読者へ説明を組み立てる仕事は、同じ基準で決める必要はありません。今回、日々のニュース要約はQwenへ移し、ニュースレターの制作は従来方式を維持します。モデルの能力を一律に評価するのではなく、それぞれの成果物に何を求めるかで使い分ける。この判断を、他のプロジェクトでも活かしていきたいと考えています。