カタパルトスープレックスでは、海外のテクノロジーやビジネスの情報をまとめたニュースレターを毎週Substackで配信しています。そのために、フロンティアモデル(Codex/Claude Code)の自作スキルを使っています。
今回はフロンティアモデルの利用トークンの削減を目的に、スキルにローカルLLMのQwen 3.8の27Bモデルと、文章の分類・選択を担うTypeSafe AIのJevを活用した実験を行いました。はじめにお伝えしておくと、削減効果のほとんどはローカルLLMによるもので、Jevの効果は限定的でした。
ローカル環境はMac Studio M5 Ultra(標準構成:CPU 30コア/GPU 60コア/メモリ 96GB/ストレージ 1TB)です。現時点でのMac Studioでも標準構成ではQwen 3.8 27Bを動かすにはコンテキストをなるべく小さくしなければいけません。そのためにJevを使います。
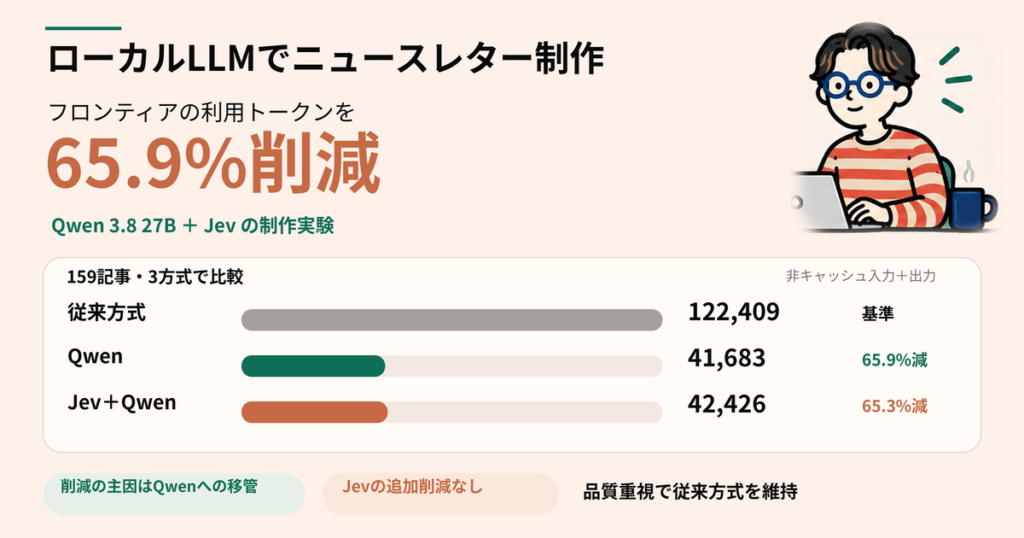
最新の比較では、同じ159記事からニュースレターを作る三つの方式を試しました。フロンティアモデルで制作する従来方式に対し、Qwenで制作する方式ではフロンティアの利用トークンを65.9%、Jevによる原文箇所の選択を加えたQwen方式では65.3%削減できました。いずれも、非キャッシュ入力と出力を合計した数値です。
Qwenは整理・構成・執筆を引き受け、フロンティア側の仕事を減らしました。Jevは原文箇所を選び、その選択情報をQwenへ渡せました。一方、当初期待した、週全体の記事を仕分け・集約してQwenが扱える粒度にする使い方は、全体比較では未検証です。
この記事では、期待したこと、試した範囲、結果を順に紹介します。トークン削減と原稿の採用は分けて考え、ニュースレターには旧方式を維持する判断をしました。
ニュースレターの制作方法
カタパルトスープレックスのニュースレターでは、海外のテクノロジーやビジネスのニュースを毎週まとめています。日々の記事を日本語で紹介するDiscordのニュース配信をもとに、その週に何が起きたか、どんな変化があったかをテーマ別に整理し、Substackで配信しています。
このニュースレターを作る手順をまとめた自作スキルが、Katapult Weeklyです。ニュースレターそのものの名前ではありません。保存した記事を集め、材料を整理し、掲載する観点を決め、原稿を書き、校正して保存するための手順です。今回の実験で変えたのは、この制作手順の中で、どのモデルにどの仕事を任せるかという点でした。
月曜日から土曜日までに収集した記事を対象に、4,000字前後の本文を作ります。AI製品、設備投資、著作権、監視技術などの記事をまとめ、前週までの動きとつなげ、読者が状況をつかめる順序に並べます。
目的はスキルのトークン削減と、モデルの使い分けの知見獲得
目的は、制作の効率化、フロンティアモデルのトークン削減、JevとQwenの使い方の調査です。記事の材料づくりや社内調査など、他のプロジェクトでも使える知見を残したいと考えました。
ここでいうフロンティアモデルは、CodexやClaude Codeなどから使う高性能なクラウドのモデルです。今回の比較では、従来方式の制作をGPT-6.1 Sol、日本語校正をGPT-6 Lunaが担当しました。新方式では、制作をローカルのQwenへ移し、フロンティアモデルの担当を日本語校正に絞っています。
トークンは、モデルが文章を読む・書くときの処理単位で、日本語の文字数と一対一には対応しません。長い資料を何度も読ませたり、長い会話を引き継いだりすると入力が増えます。今回減らしたかったのは、フロンティア側のこうした利用です。
企画上の目標は、従来の基準値600,000トークンに対して300,000以下にすることでした。ただし、最新の比較に使った従来方式も、実行方法をコードにまとめるなどの整理によって122,409トークンになっています。600,000からの減少を、そのままQwenやJevの効果とすることはできません。この記事で示す65.9%と65.3%は、同じ条件で試した従来方式122,409トークンに対する削減率です。
Qwen自身のトークン数は、この削減目標には含めませんでした。Mac Studio上で動くローカルLLMなので、トークンごとのクラウドAPI料金を減らす話とは異なります。機器の負担や処理時間は考慮する必要がありますが、扱える量と許容時間の範囲なら、Qwenの入力や出力が増えてもかまいません。
当初の構想は、前処理・制作・後処理の分担だった
当初は、Jevが前処理を担当し、Qwenが整理と執筆を行い、最後に軽量なフロンティアモデルが日本語を校正する分担を考えました。Qwenだけに、記事の収集から工程管理、校正、保存までを任せる構想ではありません。モデルがシンプルな仕事をできる条件を前段で整え、後段で文章を完成させる方針です。
Jevには、二つの使い方を考えました。一つ目は、Qwenが扱える粒度に資料を整理することです。記事をトピックや出来事ごとに仕分けし、多かった話題の必要情報を集め、Qwenへ順番に渡せる量にします。大量の原文を一度に渡すことが難しくても、この前処理が成立すれば、扱える範囲が広がると期待しました。
二つ目は、具体的な問いに答える原文箇所の選択です。ある数字の根拠や、出来事の経緯を述べた段落を候補から選ばせます。選んだ場所をコードで取り出し、出典と文脈を保ったままQwenへ渡す使い方です。一つ目を実現するための部品にもなり得ますが、限定した問いに答える箇所を選べることと、週全体の資料を適切に整理できることは別に確かめる必要があります。
Jevには、要約文や本文を書かせず、TypeSafe AIの公式例にあるChoiceとNoulによる選択機能を使いました。どこを選ぶかはJev、原文を取り出すのはPython、その材料から文章を書くのはQwenという分担です。
この構想と、最終的に試した工程には違いがあります。最新の三方式比較では、Pythonで資料を小分けにしました。Jevに週全体の仕分け・集約を任せたわけではなく、一つの記事の四段落から根拠箇所を選ぶ限定した利用です。この違いを押さえないと、Jevを加えてもトークンが減らなかったことから、当初の前処理が不要だったと誤って結論づけてしまいます。
Qwenには長い規約より、原文と短い依頼を渡す
Qwenを使う方針は、それまでMac Studioで行ったニュース系の試行から決めました。校正規約の全文や複雑な前提を取り込ませるより、原文を素直に渡し、短く直接的に依頼した方がよい結果が出ました。工程全体を理解させようとするのではなく、いま処理する資料と仕事を明確にする方法です。
初期試行では、細かく選んだ原文箇所だけを渡した結果、批判する側の発言を、批判される企業の発言として整理する例がありました。発言者と引用の前後がわかる段落を残すと改善しました。コンテキストを小さくする工夫は、文章の前後関係を切り捨てることではありません。
仕事を分けすぎることにも負担がありました。同じ材料を「事実」「検証方法」「反論」の三つの要求に分けた試行では、入力が約三倍になり、応答時間も一括処理の約二倍になりました。細かな分割を一律に増やすのではなく、必要な文脈を残して、簡潔な依頼で処理する方針にしました。
使用したQwenは導入済みのローカルモデルで、Ollama経由で逐次実行しました。一要求に渡す資料と指示を12,000 UTF-8バイト以内、出力を1,800トークン、待機を60秒とする実験条件を使いました。これは今回の実行条件で、Qwen全般の性能上限を表す数字ではありません。
実際にQwenへ渡す量を調整したのはJevではなくPython
全体比較で資料をQwenが処理できる量に分けたのは、Pythonの処理です。保存済みの記事と原文を取り出し、記事・段落の位置と出典を付け、原文順や記事の境界を保ちながら、一要求の入力上限に合わせて材料を区切りました。その材料をQwenへ順番に渡し、Qwenが返した整理を構成づくりの入力に使います。詳細な原文は、記事や段落のIDから取り出す形です。
Pythonが行ったのは、主に資料の取出し、量の調整、送信順序の管理です。内容を読んで何が重要か判断し、掲載する材料を選び、文章にする仕事はQwenが担当しました。Jevが全記事の意味を判定してQwen向けの量に集約した、という実装ではありません。Pythonによる分割で今回の制作は進みましたが、それが意味に基づく仕分け・集約を代替できると一般化したわけでもありません。
Jevで資料を小さくする試行は、可能性と限界の両方が見えた
まず、記事の仕分けに向けて、六組の記事が同じ出来事を扱っているかをJevに判定させました。六組とも事前に想定した結果と一致しました。ただし、続報や訂正、情報が不足した記事の難しい境界は試していません。ニュースのまとまりを作る補助としては手応えがありましたが、週全体の分類が成立したという結果ではありません。
次に、数学に関する二本の記事から、Qwenへ渡す材料を選ぶ試行を行いました。Jevの質問をQwenの整理項目に合わせ、選んだ箇所を含む段落をコードで取り出し、原文順に渡しました。この試行では、人が原文箇所を追加したり差し替えたりしていません。
この小規模試行では、同じ二本の記事について、全文をQwenへ渡す場合と、Jevが選んだ段落だけを渡す場合で、Qwenの入力トークンを比較しました。全文では1,441トークン、選んだ段落だけでは632トークンで、入力は約56.1%減りました。検証方法、批判、提言も整理できました。
一方で、OpenAIが述べた計算量の主張が抜けました。一つの整理項目に対して代表箇所を一つ選ぶ方法では、複数の数字や留保を残しきれない例がありました。必要な項目の一部を整理できたことを、記事の情報を十分に保持できた証拠にはできません。
この約56.1%は、二本の記事を使った小規模試行でのQwen入力だけの削減率です。ニュースレター全体で測ったフロンティア利用の65.3%減とは、対象も指標も異なります。Jevの選択でQwenの入力を減らせましたが、必要情報を残す選び方には課題が残りました。
フロンティア側の二重作業をなくすと、Qwenの効果が出た
制作全体の実験では、最初からトークンが減ったわけではありません。途中では、Qwenを導入した方がフロンティアモデルの利用量が増えました。フロンティア側が資料を選び、依頼を作り、Qwenの結果を読み、原文と照合し、別のモデルへ文章の組立を頼み、さらに修正する工程になっていたからです。
これでは、Qwenに仕事を渡しても、フロンティア側が同じ資料を読み直しています。モデルを加えるだけでなく、移した仕事をフロンティア側から外す必要がありました。
そこで、新方式ではフロンティアモデルに制作の主担当や監督を置かず、Qwenが制作し、Pythonが収集、逐次実行、保存を進める形にしました。Qwenの生成後にフロンティアが帰属や条件を確認したり、本文を組み立て直したりする工程は外しています。フロンティアを使うのは、完成原稿の日本語校正だけです。
円換算、記事数の集計、出典リンクの接続、保存先への書込みといった機械的な処理もPythonに任せました。文章生成を必要としない操作にモデルの会話を挟まないことが、制作をQwenへ移す工夫と一緒に効いています。
今回の削減率はQwen単体の性能値ではなく、制作をQwenへ移し、二重作業を外し、実行をPythonにまとめた工程の比較です。
yomiyasuは、完成原稿の日本語を整えるために使った
日本語の校正には、yomiyasuを使わせていただきました。モデルそのものではなく、文章を見直す際の規律です。曖昧な主述関係、翻訳調の言い回し、不自然な比喩、名詞を詰め込んだ表現などを対象にします。
最新の比較では、三方式の完成原稿をそれぞれ一人が一回だけ校正しました。担当はGPT-6 Lunaです。従来方式ではGPT-6.1 Solの原稿を、Qwen方式ではQwenの原稿を、同じ文章規律で整えています。校正の入力と出力も、フロンティア利用の集計に含めました。
校正者が最小限の語句修正をした本文を一回で返し、Pythonが保存する方式にしました。本文や見出しを別々の担当へ渡したり、生成担当へ修正を戻したりする往復は外しました。
最新の全体比較では、三つの方式で同じ159記事を使った
比較対象は、2026年9月28日から10月3日までに収集した159記事です。10月5日配信分としてまとめたニュースレターを題材にしました。保存済み原文がある98記事には原文を使い、残り61記事には生成済みの日本語要約を使っています。
三方式では、対象記事、前週までの経緯、為替レート、掲載する七つの観点をそろえました。従来方式、JevなしのQwen方式、Jevで原文箇所を選ぶQwen方式を各一回試し、本文、ファクトシート、全対象記事の参照を保存し、再読込と継続テーマの更新まで進めています。
ただし、三つ目の方式でも、Jevが159記事を分類・集約したわけではありません。Jevを使ったのは、OpenAIの公開報告の四段落から、指定した経緯を述べた箇所を選ぶ一回だけです。Qwenの資料はPythonですでに分割してあり、Jevの選択情報を原文材料に追加して渡しました。
| 指標 | 従来方式 | Qwen | Jev+Qwen |
|---|---|---|---|
| フロンティア入力合計 | 133,575 | 49,409 | 49,389 |
| うちキャッシュ入力 | 23,296 | 11,008 | 11,008 |
| フロンティア出力 | 12,130 | 3,282 | 4,045 |
| 非キャッシュ入力+出力 | 122,409 | 41,683 | 42,426 |
| 従来方式からの削減率 | ― | 65.9% | 65.3% |
| フロンティアの起動回数 | 2回 | 1回 | 1回 |
| 本文字数 | 4,293字 | 3,383字 | 3,318字 |
| 主要リンク数 | 15本 | 14本 | 14本 |
キャッシュ入力は入力合計の一部です。主指標は入力合計からキャッシュ入力を引き、出力を足した値です。推論に使った出力をさらに加算していません。QwenやJevの利用トークンは、このフロンティアの集計とは別に扱っています。
Qwenは制作を引き受け、フロンティア利用を65.9%減らした
Qwen方式のフロンティア利用は、従来方式122,409トークンに対して41,683トークンでした。65.9%減です。従来方式でフロンティアが担当していた整理、材料選択、構成、執筆をQwenへ移し、フロンティアの起動を制作と校正の二回から、校正だけの一回に減らせました。
Qwen自身は、制作報告を含め67回の要求を処理し、入力140,962、出力16,835トークンを使いました。前後の処理をPythonと校正担当へ分け、原稿の保存まで進められました。ローカル側の処理量は増えますが、フロンティア側の負担を減らす目的に沿った分担です。
確認できたのは、この分担で原稿を制作し、フロンティア利用を減らせたことです。従来方式と同じ内容・同じ読みやすさだったとは判断していません。
Jevの根拠箇所の選択は動いたが、追加削減は見られなかった
全体比較でJevに渡した問いは、「人が警報を確認したが自動停止せず、その後に手動で止めたと明記している箇所はどれか」というものでした。四つの候補段落から、その経緯を述べた段落を選び、Qwenが読む原文材料へ選択情報を渡すところまで実行できました。
Jevの処理は一回、約0.39秒でした。入力1,513・出力182トークンで、公開単価による費用換算は約0.000064米ドルです。実際の引落額は確認していません。指定した問いに対応する場所を短時間で選び、制作工程に接続できたことが、この用途で確認できた結果です。
一方、フロンティア利用はJevなしQwenの41,683トークンに対し、Jevありでは42,426トークンでした。従来方式より65.3%少ないものの、JevなしQwenより743トークン、約1.8%多くなりました。Jevを加えたことで、さらにフロンティア利用が減ったという結果ではありません。
Qwenの利用量も、Jevありでは入力142,966、出力17,418トークンと増えました。二本の記事の小規模試行では選んだ段落だけを渡して入力を減らしましたが、全体比較では一箇所の選択情報を追加した使い方です。同じ「Jevを使った実験」でも、材料の渡し方が違うため、入力削減をそのまま再現する比較にはなっていません。
時間と読みやすさまで改善したとは言えない
制作時間は、従来方式が保存終了まで約4分11秒、Qwen方式が約23分11秒、Jev+Qwen方式が約22分56秒でした。新方式の二つには約15〜16分の修正・指定待ちが含まれます。Qwenが返した短縮記事IDをコードが扱えず、本文制作前に停止したためです。
一意に対応するIDはコードで解決し、複数の記事に一致したものは対象記事を指定して続行しました。保存済みの構成と整理を使って再開し、Jevも再送していません。こうした回復を含む実測なので、正常に一回で完成する場合の制作時間を示すものではありません。
Jevありの方が約15秒速かったことを、Jevの時間短縮効果とは扱いません。修正待ちを含む一回ずつの試行であり、比較したい処理だけの差になっていないからです。通常の制作時間を短くできることや、従来方式の三倍以内に収まることは、今回の実測では確認できていません。
本文の長さも、従来方式4,293字、Qwen方式3,383字、Jev+Qwen方式3,318字と違いました。短くなれば読者の負担が減る場合もありますが、必要な背景説明が減る場合もあります。同じ記事と掲載観点を使ったこと、リンク数が近いことだけでは、同等品質とは判断できません。
期待したことに対して、どこまで結果が出たか
| 期待したこと | 今回の結果 |
|---|---|
| Qwenへ制作を移し、フロンティア利用を半分以下にする | 従来方式比65.9%減。Jevの限定選択を加えた方式も65.3%減で、両方が目標を満たした |
| Jevで仕分け・集約し、Qwenが扱える粒度にする | 小規模試行で入力削減を確認したが、情報の抜けが残った。週全体の仕分け・集約は未検証 |
| Jevで根拠箇所を選ぶ | 選択情報をQwenへ渡せた。制作全体の追加削減や内容改善は未確認 |
| 制作時間と読みやすさも含めて効率化する | 修正待ちを含む実測で、通常の時間短縮と同等品質は未確認 |
Qwenが扱える量にするための前処理は必要でしたが、今回その量の調整をしたのはPythonです。この条件でJevなしでも制作できたことを、意味に基づくJevの仕分け・集約が不要だという判断には広げません。他の案件へ使う際も、資料量と必要な文脈を、その用途に合わせて考える必要があります。
ニュースレターには、読みやすさを優先して旧方式を維持する
先行する原稿比較で旧方式とQwen方式を読み比べたとき、私は旧方式の内容の方がよいと判断しました。その原稿を通常のVaultに取り込み、ニュースレターには従来の制作方法を維持しています。最新の三方式比較でトークン削減を確認したことは、この編集判断とは別です。
社内の材料整理であれば、後で自分が読むことを前提に、短い説明や箇条書きでも役に立ちます。Qwenへ整理と執筆を任せる方法は、そのような用途で使う余地があります。Jevも、問いが具体的で、選ぶ候補が明確な材料探しでは使い方を絞れます。
一方、カタパルトスープレックスのニュースレターは、広い読者に読んでもらう文章です。専門用語や前週までの経緯を知らない人にも、なぜその話題を取り上げるのか、個々のニュースがどうつながるのかを伝えたいと考えています。読みやすさは、一文の日本語を校正するだけでなく、説明の順序や背景の置き方にも関わります。
トークン削減は魅力的です。それでも、このニュースレターでは、旧方式で使うトークンを読みやすさのための必要なコストと考えています。制作スキルであるKatapult Weeklyの効率と、そこで作るニュースレターが読者にとってわかりやすいかを両方見たうえで、今回は旧方式を維持します。